Matrizes (Arrays Bidimensionais): Linhas e Colunas
Eleve seu raciocínio algorítmico da linha reta para o plano cartesiano. Descubra as Matrizes: como modelar tabuleiros, coordenadas e grades na memória do computador, entenda o achatamento físico em Row-Major Order e domine a dança dos laços aninhados implementando o clássico Jogo da Velha.
1. O Salto Dimensional: Da Linha Reta à Grade Cartesiana
Nas Aulas 21 a 23, exploramos com maestria os Vetores Unidimensionais. Um vetor é como uma rua de mão única com casas numeradas: para encontrar qualquer elemento, você precisa de apenas uma única informação — o seu número de índice (uma dimensão linear).
Entretanto, o mundo real e a engenharia de software não são unidimensionais. Considere os seguintes problemas que você inevitavelmente enfrentará na sua carreira como programador:
- Jogos de Tabuleiro: Um tabuleiro de xadrez possui 8 linhas e 8 colunas (64 casas). O Jogo da Velha (Tic-Tac-Toe) possui uma grade 3x3. A Batalha Naval utiliza coordenadas como
(B, 5). - Imagens Digitais e Vídeos: Uma foto em resolução Full HD é uma grade retangular contendo 1080 linhas horizontais por 1920 colunas verticais de pixels coloridos.
- Planilhas Financeiras (Excel / Google Sheets): Tabelas contábeis organizadas por Linhas (meses do ano) e Colunas (categorias de despesas).
- Mapas Geográficos e GPS: Grades de latitude e longitude que dividem o globo em quadrantes espaciais.
Tentar modelar esses cenários utilizando vetores unidimensionais puros resultaria em cálculos manuais confusos e código ilegível. Para resolver essa demanda com elegância nativa, a computação desenvolveu as Matrizes (Arrays Bidimensionais).
2. O Que É uma Matriz? O Conceito de Linhas e Colunas
Uma Matriz é formalmente definida como uma estrutura de dados homogênea bidimensional composta por um conjunto de elementos do mesmo tipo de dado, organizados em uma grade de $M$ linhas por $N$ colunas ($M \times N$).
Para localizar qualquer valor dentro de uma matriz, precisamos obrigatoriamente de um Par Ordenado de Índices:
matriz[linha, coluna] ou matriz[i][j]
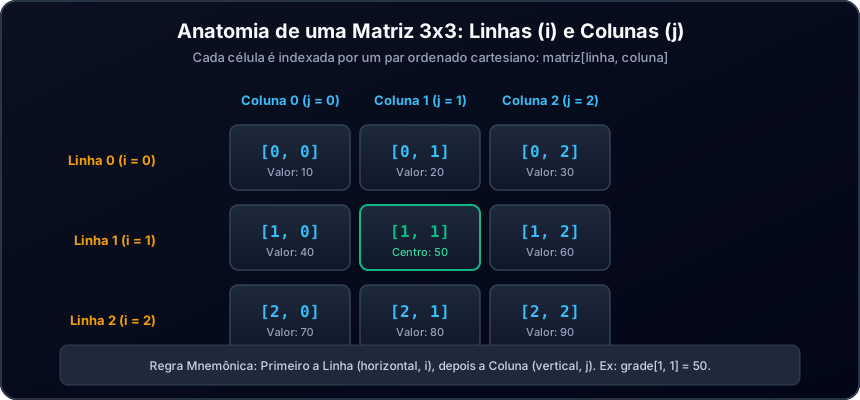
Figura 1: Anatomia de uma matriz 3x3. Convenção universal: o primeiro índice representa a Linha (i) e o segundo índice representa a Coluna (j).
Lembre-se sempre da sigla "LC" (Linha / Coluna):
- Primeiro Índice (
i): A coordenada Horizontal (Linha). Conta de cima para baixo:0, 1, 2... - Segundo Índice (
j): A coordenada Vertical (Coluna). Conta da esquerda para a direita:0, 1, 2...
Assim, a célula grade[0, 2] está na primeira linha (linha 0) e na terceira coluna (coluna 2).
3. Mapeamento da Matriz na Memória RAM: A Ilusão da Grade
Aqui reside uma das revelações mais fascinantes da arquitetura de computadores: a memória RAM não é bidimensional!
Fisicamente, a memória RAM do seu computador é uma fita contígua puramente linear de bytes (unidimensional). Os pentes de memória não possuem "linhas e colunas físicas" dispostas no formato de tabuleiro. Como, então, a máquina consegue guardar uma grade 2D em uma fita 1D?
Ela faz isso através de um processo chamado Achatamento de Memória (Flattening). A esmagadora maioria das linguagens de programação ocidentais (C, C++, Java, C#, Python, JavaScript, Rust, Go) adota a convenção denominada Row-Major Order (Ordem por Linhas).
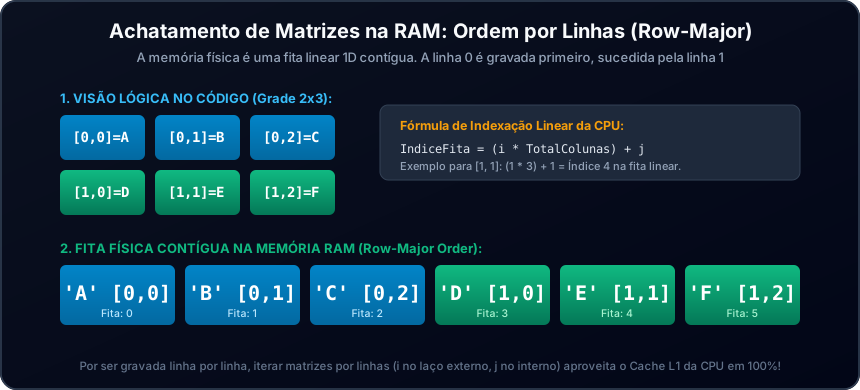
Figura 2: O padrão Row-Major Order. Todos os elementos da Linha 0 são gravados primeiro de forma contígua, seguidos imediatamente pelos elementos da Linha 1.
A Matemática do Acesso Instantâneo em Tempo $O(1)$
Quando seu código solicita o elemento na posição matriz[i, j] de uma matriz que possui um total de $C$ colunas, o processador calcula o endereço físico linear instantaneamente por meio da seguinte fórmula:
ÍndiceLinearNaRAM = (linha × TotalDeColunas) + coluna
Para uma matriz com 3 colunas, a célula matriz[1, 1] (segunda linha, segunda coluna) terá seu índice linear calculado como:
(1 × 3) + 1 = 4 (exatamente o 5º elemento contíguo na fita da RAM).
Graças a essa multiplicação e adição direta de registradores de CPU, o acesso a qualquer célula de uma matriz bidimensional continua sendo $O(1)$ (tempo constante)! Não há lentidão em acessar o meio ou o final da grade.
4. Declaração e Acesso a Matrizes no logicabr.dev
Vejamos a sintaxe estruturada para declarar e manipular matrizes em pseudocódigo:
// Declaração e inicialização de matriz 3x3 no logicabr.dev
numero grade[3][3] = [[10, 20, 30], [40, 50, 60], [70, 80, 90]];

// Leitura de coordenadas específicas [linha][coluna]
saida("O elemento do canto superior esquerdo é: " + grade[0][0]);
saida("O elemento central é: " + grade[1][1]);
saida("O elemento do canto inferior direito é: " + grade[2][2]);
5. A Dança dos Laços Aninhados: Varredura Eficiente de Matrizes
Assim como um vetor 1D se casa com perfeição com um laço para simples, uma matriz 2D exige dois laços para aninhados para ser percorrida em sua totalidade.
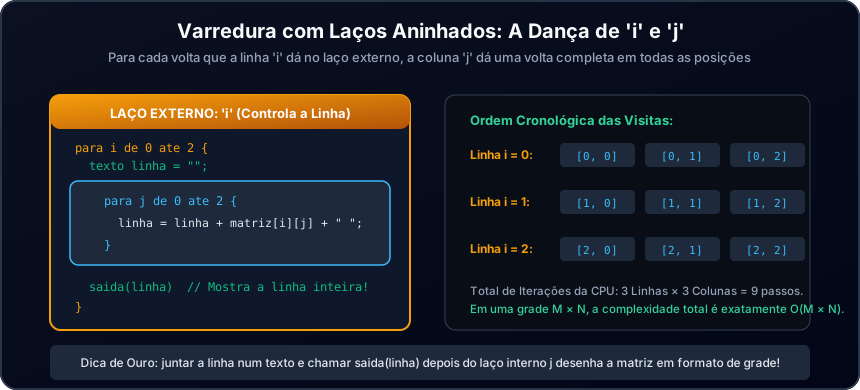
Figura 3: A travessia de uma matriz 3x3 com laços aninhados. O laço externo fixa a linha enquanto o laço interno percorre todas as colunas daquela linha.
O Padrão Clássico de Impressão em Formato de Grade
Observe o código a seguir. Preste atenção especial em onde montamos a linha (concatenando os elementos no texto linhaVisual, sem pular linha) e onde chamamos saida (que imprime e quebra a linha):
numero tabuleiro[3][3] = [[1, 2, 3], [4, 5, 6], [7, 8, 9]];

saida("--- VISUALIZAÇÃO EM GRADE 3x3 ---");

// LAÇO EXTERNO: Percorre cada LINHA (i)
para (numero i = 0; i < 3; i++) {
    texto linhaVisual = "";

    // LAÇO INTERNO: Percorre cada COLUNA (j) daquela linha
    para (numero j = 0; j < 3; j++) {
        linhaVisual = linhaVisual + tabuleiro[i][j] + "  ";
    }

    // Imprime a linha inteira formatada no console
    saida(linhaVisual);
}
A saída impressa no console será uma grade perfeitamente alinhada:
1  2  3
4  5  6
7  8  9
Por que sempre colocamos o laço da Linha (i) por fora e o laço da Coluna (j) por dentro?
Como vimos na Figura 2, a memória RAM física armazena a matriz em Row-Major Order. Ao variar a coluna j no laço interno, estamos acessando células vizinhas coladas umas às outras na RAM física. Quando o processador lê [0, 0], ele já carrega [0, 1] e [0, 2] diretamente para o seu Cache L1 ultrarrápido!
Se você invertesse a ordem dos laços (colocando coluna por fora e linha por dentro), o computador seria forçado a dar "saltos" gigantescos de memória a cada iteração, causando centenas de Cache Misses e tornando o algoritmo até 10 vezes mais lento em matrizes de grande porte!
6. Laboratório Multi-Linguagem: Matrizes no Mundo Real
Em linguagens de alto nível como JavaScript e Python, matrizes são representadas elegantemente como Arrays de Arrays (ou listas aninhadas):
// ==============================================
// JAVASCRIPT (ES6+ Array de Arrays)
// ==============================================
const matrizJS = [
  [10, 20, 30],
  [40, 50, 60],
  [70, 80, 90]
];

// Acesso via notação de colchetes duplos [linha][coluna]:
console.log("Centro:", matrizJS[1][1]); // 50

// Varredura clássica:
for (let i = 0; i < matrizJS.length; i++) {
  let linhaTexto = "";
  for (let j = 0; j < matrizJS[i].length; j++) {
    linhaTexto += matrizJS[i][j] + " ";
  }
  console.log(linhaTexto);
}

// ==============================================
// PYTHON 3 (Listas Aninhadas)
// ==============================================
matriz_py = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

print("Centro:", matriz_py[1][1]) # 50

# Varredura em Python:
for linha in matriz_py:
    print(" ".join(str(val) for val in linha))
7. O Cálculo de Consumo de Memória RAM e o Caso dos Pixels Digitais
Enquanto um vetor de inteiros de 100 posições consome uma quantidade desprezível de memória (apenas 400 bytes), as matrizes crescem de forma multiplicativa ($M \times N$). Essa propriedade geométrica exige que desenvolvedores compreendam exatamente quanto espaço físico suas grades estão consumindo nos servidores e dispositivos móveis.
A fórmula matemática para calcular a pegada de memória RAM de qualquer matriz homogênea é:
BytesTotais = Linhas × Colunas × TamanhoDoTipoEmBytes
Considere o display do seu computador ou smartphone:
- Uma imagem em resolução Full HD possui 1080 linhas por 1920 colunas (2.073.600 pixels).
- Cada pixel colorido no padrão RGBA necessita de 4 bytes (1 byte para Vermelho, 1 para Verde, 1 para Azul e 1 para Transparência/Alpha).
- Memória consumida:
1080 × 1920 × 4 = 8.294.400 bytesAproximadamente 8 Megabytes de memória de vídeo (VRAM) por quadro estático! - Para um jogo rodando a 60 quadros por segundo sem compactação, seriam necessários quase 500 MB por segundo só para trafegar esses quadros de pixels pela GPU.
8. Matrizes Esparsas vs Densas: Quando Armazenar Zeros se Torna um Crime
Em computação científica, simulações físicas e algoritmos de recomendação (como os da Netflix ou do Spotify), as matrizes costumam ser gigantescas: 100.000 usuários nas linhas por 500.000 músicas nas colunas.
Se tentássemos alocar essa matriz de forma densa tradicional, teríamos 50 bilhões de células! Multiplicando por 4 bytes por número inteiro, precisaríamos de 200 Gigabytes de memória RAM apenas para instanciar a grade!
No entanto, cada usuário escuta em média apenas 200 músicas. Isso significa que mais de 99,99% de toda a matriz é preenchida por zeros! Uma matriz com essa característica é chamada de Matriz Esparsa (Sparse Matrix).
Para não quebrar os servidores, a engenharia de software adota representações especiais (como Coordinate List - COO ou Compressed Sparse Row - CSR), onde registramos apenas as trincas que realmente contêm dados: (linha, coluna, valor). Assim, os 200 GB caem para meros 50 Megabytes, permitindo que o sistema rode até em um celular modesto.
9. As 5 Armadilhas Comuns com Matrizes
-
Inverter as Coordenadas na Leitura: Escrever
matriz[coluna, linha]por engano. Lembre-se sempre: Linha primeiro ($i$), Coluna depois ($j$). -
A Pegadinha das Referências Compartilhadas em Python: Inicializar uma matriz com
matriz = [[0] * 3] * 3! Essa sintaxe cria 3 referências apontando para a mesmíssima lista na memória. Ao alterarmatriz[0][0] = 5, todas as três linhas terão o elemento zero alterado para 5 simultaneamente! Use sempre list comprehension:[[0 for _ in range(3)] for _ in range(3)]. -
Extrapolar Limites em Matrizes Retangulares ($M \times N$): Se a matriz tem 2 linhas e 5 colunas, usar o mesmo limite para ambos os laços (como
i < 5) resultará em Index Out of Bounds na linha. -
Esquecer a Quebra de Linha Visual: Chamar
saidadentro do laço interno (em vez de uma vez por linha, no laço externo) faz cada elemento ser impresso numa linha separada, desmontando a grade. -
Cópia Rasa (Shallow Copy): Ao copiar uma matriz fazendo
copia = [...matrizOriginal], apenas o vetor externo é duplicado; as linhas internas continuam apontando para as mesmas áreas de memória compartilhadas.
10. Projeto Prático Resolvido: O Motor Completo do Jogo da Velha (Tic-Tac-Toe)
Para colocar a manipulação de matrizes à prova com excelência, vamos construir um motor completo do tradicional Jogo da Velha (Tic-Tac-Toe).
O sistema utiliza uma matriz 3x3 de caracteres (preenchida com '-' para representar casas vazias), alterna as jogadas entre os jogadores 'X' e 'O', valida se a casa selecionada está livre e detecta vitória horizontal ou vertical.
// =========================================================================
// MOTOR DO JOGO DA VELHA (logicabr.dev)
// =========================================================================

vetor tabuleiro = [];
tabuleiro[0] = ["-", "-", "-"];
tabuleiro[1] = ["-", "-", "-"];
tabuleiro[2] = ["-", "-", "-"];

texto jogadorAtual = "X";
numero rodada = 1;
logico houveVencedor = falso;

saida("=== BEM-VINDO AO JOGO DA VELHA LOGICABR ===");

enquanto (rodada <= 9 e nao houveVencedor) {
    logico jogadaValida = falso;

    enquanto (nao jogadaValida) {
        saida("Vez do Jogador [" + jogadorAtual + "]:");
        numero lin = entrada("Escolha a LINHA (0, 1 ou 2): ");
        numero col = entrada("Escolha a COLUNA (0, 1 ou 2): ");

        se (lin >= 0 e lin <= 2 e col >= 0 e col <= 2) {
            se (tabuleiro[lin][col] == "-") {
                tabuleiro[lin][col] = jogadorAtual;
                jogadaValida = verdadeiro;
            } senao {
                saida("[ERRO] Casa ocupada! Escolha outra.");
            }
        } senao {
            saida("[ERRO] Coordenadas inválidas! Digite de 0 a 2.");
        }
    }

    // VERIFICAÇÃO DE VITÓRIA (LINHAS E COLUNAS)
    para (numero i = 0; i < 3; i++) {
        se (tabuleiro[i][0] == jogadorAtual e tabuleiro[i][1] == jogadorAtual e tabuleiro[i][2] == jogadorAtual) {
            houveVencedor = verdadeiro;
        }
        se (tabuleiro[0][i] == jogadorAtual e tabuleiro[1][i] == jogadorAtual e tabuleiro[2][i] == jogadorAtual) {
            houveVencedor = verdadeiro;
        }
    }

    // DIAGONAL PRINCIPAL E SECUNDÁRIA
    se (tabuleiro[0][0] == jogadorAtual e tabuleiro[1][1] == jogadorAtual e tabuleiro[2][2] == jogadorAtual) {
        houveVencedor = verdadeiro;
    }
    se (tabuleiro[0][2] == jogadorAtual e tabuleiro[1][1] == jogadorAtual e tabuleiro[2][0] == jogadorAtual) {
        houveVencedor = verdadeiro;
    }

    // ALTERNA O JOGADOR SE O JOGO CONTINUAR
    se (nao houveVencedor) {
        se (jogadorAtual == "X") {
            jogadorAtual = "O";
        } senao {
            jogadorAtual = "X";
        }
        rodada = rodada + 1;
    }
}

saida("");
saida("================ FIM DE JOGO ================");
se (houveVencedor) {
    saida("[PARABÉNS]! O Jogador [" + jogadorAtual + "] VENCEU A PARTIDA!");
} senao {
    saida("[EMPATE] DEU VELHA! Ninguém venceu e o tabuleiro lotou.");
}
11. Perguntas Frequentes sobre Matrizes (FAQ)
Por que dizemos que uma matriz é um 'vetor de vetores'?
Porque, conceitualmente, uma matriz de 3 linhas pode ser compreendida como um vetor principal de tamanho 3 no qual cada posição contém, em seu interior, um outro vetor completo de 3 elementos. Em linguagens dinâmicas como JavaScript e Python, essa é literalmente a implementação física subjacente.
Qual é a diferença entre matriz esparsa e matriz densa?
Uma Matriz Densa possui a maioria de suas células preenchidas com dados significativos e úteis. Uma Matriz Esparsa possui a esmagadora maioria de seus elementos preenchida com zeros ou valores nulos (muito comum em processamento de linguagem natural e redes neurais). Em matrizes esparsas, algoritmos avançados utilizam estruturas especiais para armazenar apenas as coordenadas diferentes de zero, economizando gigabytes de memória RAM.
O que aprenderemos na próxima aula (Aula 25)?
Na Aula 25, que encerrará a Trilha 5, exploraremos as Operações Avançadas com Matrizes! Estudaremos como calcular a Diagonal Principal e a Diagonal Secundária em tempo linear $O(n)$, como gerar a Matriz Transposta (invertendo linhas por colunas) e como implementar a Soma e Multiplicação Matricial.
Pratique Matrizes e o Jogo da Velha na IDE Online!
Abra o editor interativo do logicabr.dev, execute o código do Jogo da Velha e desafie um amigo diretamente no console online.
Abrir IDE Online e Experimentar →