Complexidade de Algoritmos: Notação Big-O Intuitiva e Eficiência
Por que um algoritmo que roda em 2 milissegundos no seu computador pessoal pode derrubar os servidores de uma grande empresa quando colocado em produção? A resposta não está na velocidade dos processadores, mas na Notação Big-O: a métrica definitiva que prevê o comportamento dos seus programas quando o volume de dados explode.
1. Por Que Medir Eficiência? O Mito do "Meu Computador É Rápido"
Quando estamos aprendendo a programar, nossos testes costumam rodar com vetores de 5, 10 ou 50 números. Em volumes tão minúsculos, praticamente qualquer algoritmo — até o mais ineficiente e desleixado — parece rodar de forma instantânea: o piscar de olhos de um ser humano dura cerca de 300 milissegundos, enquanto um computador moderno executa mais de 3 bilhões de instruções por segundo.
Essa velocidade colossal cria uma falsa sensação de segurança: "Para que me preocupar com algoritmos eficientes se o hardware atual é tão potente?".
O problema surge quando a sua aplicação sai do ambiente acadêmico e vai para a vida real:
- O banco de dados de clientes deixa de ter 20 registros e passa a ter 500.000 usuários ativos.
- A lista de produtos de um e-commerce cresce para 2 milhões de itens.
- O sensor de telemetria de um aplicativo envia 50.000 leituras por minuto.
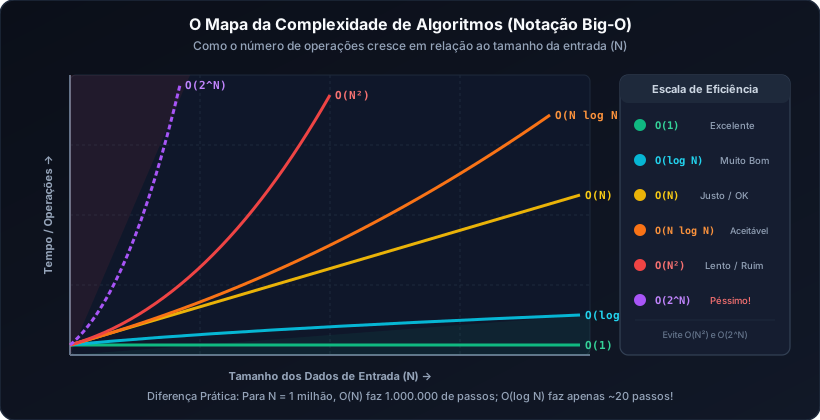
Quando a quantidade de dados (que chamamos matematicamente de N) aumenta por um fator de 1.000, um algoritmo bem projetado pode demorar apenas 10 vezes mais; enquanto um algoritmo ingênuo pode demorar 1.000.000 de vezes mais, passando de 1 fração de segundo para 3 semanas ininterruptas de processamento!
É para prever e quantificar essa curva de crescimento, sem depender do relógio ou da máquina em que o código roda, que utilizamos a Notação Big-O.
2. O Que É a Notação Big-O? A Matemática Desmistificada
A letra O vem de "Ordem de Grandeza" (Order of magnitude). O objetivo da notação Big-O não é calcular o número exato de microssegundos que o processador gastará, mas sim descrever a taxa de crescimento do tempo de execução ou do consumo de memória quando o volume de dados de entrada (N) cresce em direção ao infinito.
As Duas Regras de Simplificação Assintótica:
Para encontrar a complexidade de qualquer código, você só precisa aplicar duas regras muito simples:
-
Regra 1: Descarte as Constantes Multiplicativas:
Se um algoritmo executa exatamente2N + 5instruções, nós ignoramos o2e o5e dizemos simplesmente que ele é O(N). Por quê? Porque quandoN = 10.000.000, a diferença proporcional entreNe2Né insignificante comparada à diferença entreNeN². O fator dominante é o crescimento linear. -
Regra 2: Descarte os Termos de Menor Ordem:
Se o seu programa executaN² + 500N + 1000passos, a complexidade oficial é simplesmente O(N²). Para valores astronômicos deN, o termo quadrático (N²) cresce tão avassaladoramente rápido que os 500N tornam-se mera poeira estatística.
3. O Espectro das Complexidades Mais Comuns
Vejamos em detalhes as principais categorias de complexidade que você encontrará ao longo de toda a sua vida como programador:
A. O(1) — Complexidade de Tempo Constante (O Santo Graal)
Não importa se a sua base de dados tem 3 itens ou 3 bilhões de itens: a operação demora exatamente o mesmo tempo fixo.
O exemplo mais clássico de O(1) é acessar uma posição de um vetor pelo seu índice numérico: v[4]. Como vimos na Aula 21, o processador multiplica o índice pelo tamanho do tipo de dado e salta diretamente para o endereço físico na RAM em um único ciclo de clock. Outros exemplos: somar dois números, verificar se um número é par com numero % 2 == 0, ou ler o tamanho de um vetor armazenado em cache.
B. O(log N) — Complexidade Logarítmica (Extremamente Eficiente)
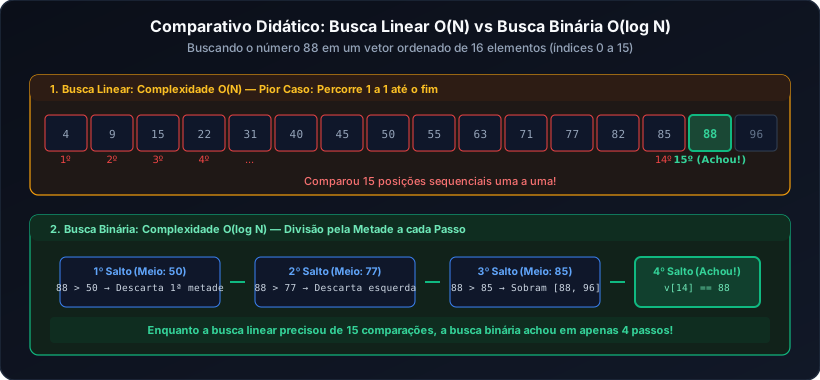
Em algoritmos logarítmicos, o tempo cresce muito lentamente porque a cada passo o algoritmo elimina metade dos dados restantes.
Pense no jogo de adivinhar um número secreto entre 1 e 100: se você chuta 50 e a pessoa diz "é maior", você acabou de descartar 50 números em um único palpite! Repetindo isso, você descobre qualquer número entre 1 e 100 em no máximo 7 palpites (\(2^7 = 128\)).
O exemplo supremo de O(log N) é a Busca Binária em vetores ordenados. Para buscar um elemento em uma lista de 1.000.000.000 (1 bilhão) de registros, a busca binária precisa de apenas 30 comparações!
C. O(N) — Complexidade Linear (Proporcional e Justa)
O tempo de execução cresce em proporção direta e reta ao tamanho da entrada. Se o tamanho de N dobra, o tempo de execução dobra.
O exemplo clássico é um laço simples que percorre um vetor do primeiro ao último elemento: encontrar o maior número em um vetor desordenado, somar todos os elementos ou imprimir uma lista na tela.
// Complexidade O(N): o laço executa exatamente N iterações proporcionais
para (numero i = 0; i < N; i++) {
    total = total + precos[i];
}
D. O(N log N) — Linearítmica (O Padrão dos Bons Ordenadores)
Algoritmos com complexidade \(O(N \log N)\) combinam uma divisão no estilo dividir-para-conquistar (\(\log N\)) com uma varredura linear em cada nível (\(N\)).
É a eficiência teórica ótima para ordenar listas baseadas em comparações. Algoritmos famosos como Merge Sort, Quick Sort (caso médio) e TimSort (o algoritmo padrão utilizado internamente pelo Python e Java) operam em \(O(N \log N)\). Para ordenar 1 milhão de itens, eles realizam cerca de 20 milhões de operações — o que leva poucos milissegundos em qualquer computador moderno.
E. O(N²) — Complexidade Quadrática (O Perigo dos Laços Aninhados)
Em algoritmos quadráticos, o tempo cresce com o quadrado da entrada. Se você dobrar os dados (de 1.000 para 2.000), o tempo é multiplicado por 4. Se multiplicar os dados por 10, o tempo é multiplicado por 100!
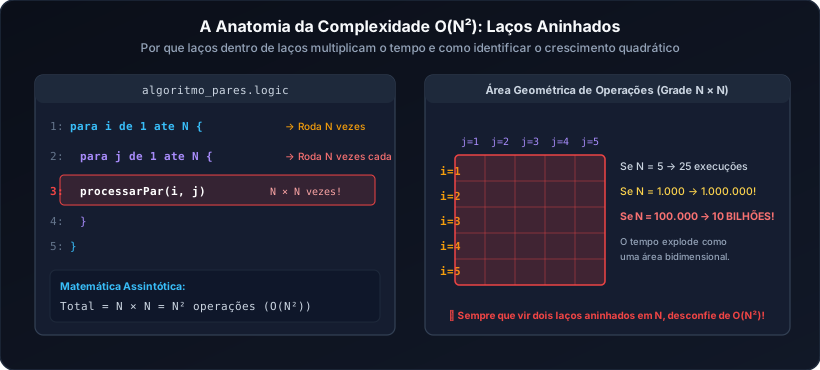
Algoritmos elementares de ordenação como o Bubble Sort (que estudamos na Aula 23), Selection Sort e Insertion Sort são \(O(N^2)\). Para 100 itens, 10.000 operações passam despercebidas. Mas para 1 milhão de itens, \(10^{12}\) operações exigiriam cerca de 15 a 20 minutos de processador a 100%!
F. O(2^N) e O(N!) — Complexidade Exponencial e Fatorial (A Zona do Colapso)
Adicionar um único elemento a mais à entrada dobra o tempo total de execução. Algoritmos como a sequência de Fibonacci recursiva ingênua (sem memorização) ou força-bruta para o Problema do Caixeiro Viajante pertencem a este grupo.
Para \(N = 50\), \(2^{50}\) é mais de 1 quatrilhão de operações. Mesmo o supercomputador mais veloz do planeta levaria anos para concluir. Na prática da engenharia, algoritmos exponenciais são inviáveis para conjuntos de dados de tamanho real sem heurísticas de otimização.
4. Complexidade Espacial: O Custo na Memória RAM
Muitos programadores esquecem que a Notação Big-O não se aplica exclusivamente ao tempo de CPU. Ela também mede a Complexidade Espacial (Space Complexity): quanta memória RAM adicional o algoritmo aloca em função de N.
-
O(1) Espacial (In-Place): O algoritmo utiliza apenas algumas variáveis auxiliares escalares (como
i,temp,soma). Ele não cria novos vetores proporcionais a N. - O(N) Espacial: O algoritmo cria uma cópia ou um vetor auxiliar do mesmo tamanho da entrada para realizar seu trabalho (como o Merge Sort, que precisa de um vetor temporário para mesclar as metades).
- O(N) na Pilha de Chamadas (Call Stack): Uma função recursiva com profundidade N (como uma recursão que chama a si mesma N vezes antes de retornar) consome memória na pilha para guardar os frames de chamada, mesmo que não crie nenhum vetor!
5. Como Identificar a Notação Big-O Olhando para o Código
Com um pouco de prática, você conseguirá inferir a complexidade de quase qualquer trecho de código em segundos:
- Instruções sequenciais simples:
x = 10; y = 20; retorno x + y;→O(1). - Um laço simples de 0 a N:
para (numero i = 0; i < N; i++)→O(N). - Dois laços independentes consecutivos:
para (numero i = 0; i < N; i++)seguido depara (numero j = 0; j < N; j++)→ \(O(N + N) = O(2N) = \mathbf{O(N)}\) (não confunda laços consecutivos com laços aninhados!). - Dois laços aninhados (um dentro do outro):
para (numero i = 0; i < N; i++) { para (numero j = 0; j < N; j++) { ... } }→ \(O(N \times N) = \mathbf{O(N^2)}\). - Laço que dobra ou divide o contador por 2:
enquanto (i < N) { i = i * 2; }→ \(\mathbf{O(\log N)}\).
6. Laboratório Multi-Linguagem: Cronometrando Eficiência
Veja como medir tempos e ciclos de execução de forma prática em diferentes ecossistemas:
const N = 100000;
const lista = Array.from({ length: N }, (_, i) => i);

console.time("Busca Linear O(N)");
const achouLinear = lista.includes(N - 1);
console.timeEnd("Busca Linear O(N)");

console.time("Acesso Direto O(1)");
const itemDireto = lista[N - 1];
console.timeEnd("Acesso Direto O(1)");import time
n = 200000
dados = list(range(n))
inicio = time.perf_counter()
# Operação O(1): verificação de comprimento
tamanho = len(dados)
fim = time.perf_counter()
print(f"Tempo O(1): {(fim - inicio)*1000:.6f} ms")#include <stdio.h>
#include <time.h>
void teste_linear(long n) {
clock_t inicio = clock();
long soma = 0;
for (long i = 0; i < n; i++) {
soma += i;
}
clock_t fim = clock();
double tempo = (double)(fim - inicio) / CLOCKS_PER_SEC;
printf("Tempo O(N) para %ld elementos: %f seg\n", n, tempo);
}7. 5 Armadilhas Clássicas de Desempenho em Aplicações
- O Problema da Consulta N+1 em Laços: Fazer uma busca ou requisição dentro de um laço de repetição. Se o laço roda N vezes e cada iteração faz uma busca linear de tamanho N, o algoritmo que parecia inofensivo vira um terrível \(O(N^2)\).
-
Concatenação de Strings em Laços Ingênuos: Em linguagens onde strings são imutáveis (como Python e Java antigo), fazer
texto = texto + novoCaracteredentro de um laço copia a string inteira na memória a cada repetição, transformando uma simples leitura em \(O(N^2)\). Use buffers ou arrays de junção (join). -
Busca Linear em Listas Não Indexadas: Usar
indexOf,includesou busca sequencial repetidamente dentro de um laço de comparação de dois conjuntos. Para checar pertinência rápida em \(O(1)\), utilize tabelas hash (dicionários / conjuntos / sets). -
Remoção do Primeiro Elemento em Vetores: Fazer
shift()ou remover o índice zero de um vetor de tamanho N obriga o computador a deslocar todos os outros N-1 elementos uma casa para trás na memória (\(O(N)\)). - Confundir Pior Caso com Caso Médio: Assumir que o Quick Sort sempre será \(O(N \log N)\) sem saber que, se o pivô for mal escolhido em uma lista já ordenada, ele pode degradar para \(O(N^2)\).
8. Projeto Prático Resolvido: Comparativo Real entre Busca Linear e Busca Binária
O algoritmo a seguir implementa a Busca Linear e a Busca Binária sobre um vetor ordenado de 32 elementos, contando e exibindo na tela o número exato de comparações realizadas por cada método para localizar o mesmo valor:
// =========================================================================
// LABORATÓRIO COMPARATIVO: BUSCA LINEAR O(N) VS BUSCA BINÁRIA O(log N)
// =========================================================================

numero N = 16;
vetor vetorOrdenado = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100, 110, 120, 130, 140, 150, 160];
numero alvo = 150;

saida("================ EXPERIMENTO ASSINTÓTICO ================");
saida("Vetor ordenado com N = " + N + " elementos.");
saida("Elemento alvo a localizar: " + alvo);

// 1. EXECUÇÃO DA BUSCA LINEAR O(N)
numero passosLinear = 0;
numero posicaoLinear = -1;

para (numero i = 0; i < N; i++) {
    passosLinear++;
    se (vetorOrdenado[i] == alvo) {
        posicaoLinear = i;
        pare; // Encontrou o elemento
    }
}

// 2. EXECUÇÃO DA BUSCA BINÁRIA O(log N)
numero passosBinaria = 0;
numero posicaoBinaria = -1;
numero inicioIdx = 0;
numero fimIdx = N - 1;

enquanto (inicioIdx <= fimIdx) {
    passosBinaria++;
    numero meioIdx = Math.floor((inicioIdx + fimIdx) / 2);

    se (vetorOrdenado[meioIdx] == alvo) {
        posicaoBinaria = meioIdx;
        pare;
    } senao se (vetorOrdenado[meioIdx] < alvo) {
        inicioIdx = meioIdx + 1;
    } senao {
        fimIdx = meioIdx - 1;
    }
}

// ================= RELATÓRIO DE COMPARAÇÃO =================
saida("------------------------------------------------");
saida("1. Busca Linear O(N):     " + passosLinear + " comparações realizadas.");
saida("2. Busca Binária O(log N): " + passosBinaria + " comparações realizadas.");
saida("------------------------------------------------");
saida("[EFICIÊNCIA]: A Busca Binária realizou apenas " + passosBinaria + " passos contra " + passosLinear + " da busca linear!");
saida("================================================");
9. Perguntas Frequentes sobre Notação Big-O (FAQ)
A busca binária funciona em qualquer vetor?
Não! A busca binária exige que o vetor esteja obrigatoriamente pré-ordenado. Se o vetor estiver desordenado, a premissa de descartar a metade esquerda ou direita perde o sentido e a busca falhará. Se você precisa fazer apenas uma única busca em um vetor desordenado, a busca linear \(O(N)\) é preferível a ter que ordenar primeiro (\(O(N \log N)\)).
O que é a notação Big-Theta (Θ) e Big-Omega (Ω)?
Enquanto o Big-O representa o limite superior (pior caso), o Big-Omega (Ω) representa o limite inferior (melhor caso possível), e o Big-Theta (Θ) representa o limite justo e exato quando o melhor e o pior caso crescem na mesma taxa assintótica.
Por que dizemos que ordenação por comparação tem limite teórico de O(N log N)?
Matematicamente, existem \(N!\) permutações possíveis para uma lista de tamanho N. Qualquer árvore de decisão baseada em perguntas de comparação ("A é maior que B?") precisa de no mínimo \(\log_2(N!)\) folhas para distinguir todas as ordens, o que pela aproximação de Stirling equivale assintoticamente a \(\Omega(N \log N)\).
Experimente o Teste Big-O na IDE Online!
Abra o editor interativo do logicabr.dev, execute o laboratório comparativo de busca linear vs binária e altere o tamanho do vetor para sentir a diferença exponencial na prática.
Abrir IDE Online e Experimentar →